加入一个新区段
一个根原型,就能让某个层和 KV 头看到完整的上下文语义槽。
核心思想
在固定的物理缓存预算下,下一个 K/V 条目既可以覆盖一个当前缺失的区域,也可以细化一个已经被表示的区域。GraceKV 把这两种选择放到同一尺度上直接比较。
一个根原型,就能让某个层和 KV 头看到完整的上下文语义槽。
一次 Split 用预先选定的子节点集合替换一个粗粒度原型,只在细节确实值得保留的位置增加条目。
压缩发生在一次标准预填充之后。GraceKV 复用这一遍前向中已经收集的 Q/K/V、采样隐藏状态、问题区域输出与 token 惊异度;不需要额外模型前向、不需要追加训练,也不会用掩码假装被删除的条目仍然存在。
在理解当前输入之前,不会先给各层、KV 头或语义槽切出固定份额。
同一段文本在不同的层—KV 头组合中,可能需要不同的覆盖范围与局部分辨率。
“全局”只描述竞价的竞争范围覆盖所有候选位置,并不声称得到精确的组合全局最优解。
一个具体案例
问题要找出演唱《Good Little Girls》的组合成员。答案不在第一段匹配文本中:模型必须沿着两跳证据链,从歌曲找到 Blue Country,再从 Blue Country 找到 Aaron Benward。
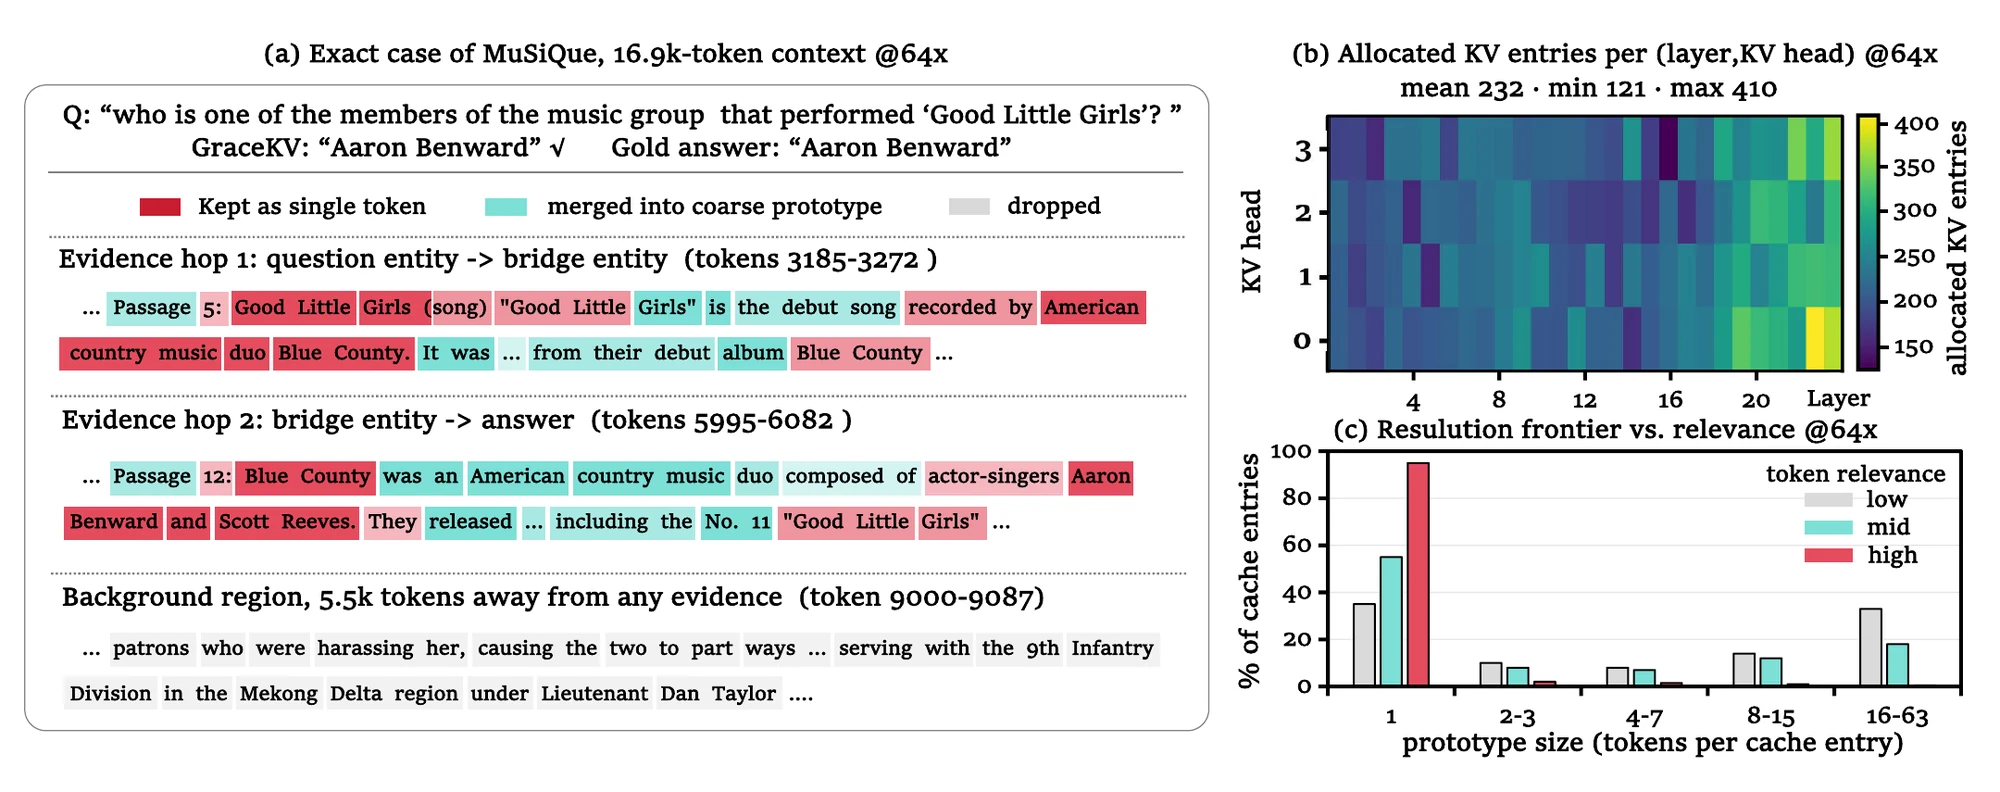
为姓名、数字、标签或其他关键证据保留原始 token 级 K/V。
当整体语境比每一处局部细节更重要时,用一个原型对一段文本做粗粒度保留。
对于这个特定的层—KV 头组合,该语义槽不写入任何物理缓存条目。
方法
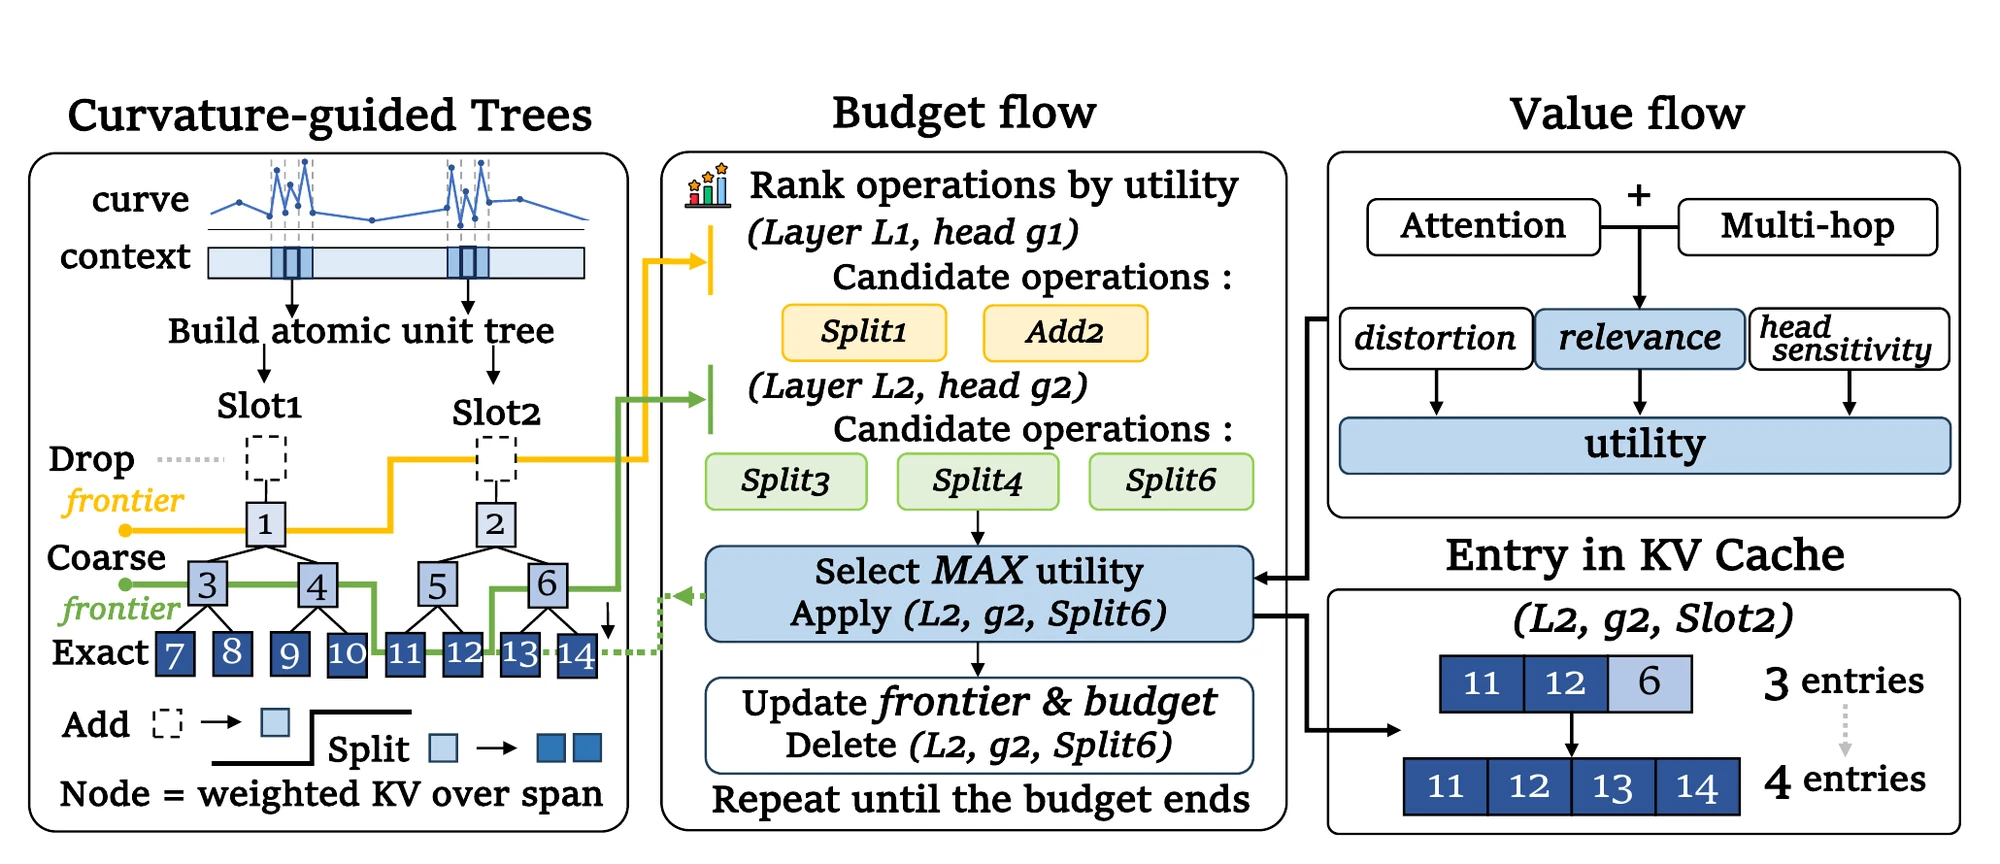
GraceKV 先为覆盖范围和局部分辨率建立一套统一的结构表达,再估计当前输入真正需要什么,让每个可行的 Add 或 Split 用同一种物理单位参与竞争。
01 · 曲率引导的划分
GraceKV 把归一化隐藏状态看作一条沿 token 位置前进的轨迹。平滑区段可以共享更长的粗粒度表示;跨层、跨窗口尺度都稳定出现的转向,则更适合作为结构边界。
Token 惊异度提供较弱的辅助信号,动态规划还会同时考虑语义槽内部离散程度与合理长度。曲率决定的是在哪里合并在结构上更安全,而不是哪些内容对当前问题更重要。
结构决定在哪里切分,相关性决定在哪里花预算。
默认目标为每个语义槽约 64 个 token,并自适应约束在 16 至 128 个 token 之间。
02 · 渐进可细化表示
所有位置共享语义槽边界,但每个 (层, KV 头, 语义槽) 三元组都拥有自己的原型树。前沿是一组互不重叠的节点,它准确说明这个原子单元如何被存储。
一个已存储原型让整个语义槽仍可被寻址,但局部 token 细节会被合并。
单个缓存条目内部
一个粗粒度节点用一条打包后的缓存表示一个连续区间。GraceKV 让这份打包表示与真正消费它的解码器保持一致。
经过 RoPE 的键处在不同旋转坐标中。GraceKV 先将其逆旋转到同一坐标系,再求平均,最后在代表位置重新应用 RoPE。
Value 按任务相关性加权,同时保留 10% 的均匀基线,使低价值背景信息也不会完全失去影响。
键的一致性决定这个原型应当等效代表多少原始 token,避免平均得到的“幽灵键”获得被夸大的注意力质量。
03 · 自底向上的价值流
来自问题与序列尾部探针的直接注意力,可以识别显式证据;随后两轮 token 到 token 的传播会恢复间接依赖,例如问题本身没有强烈关注、但推理链必须经过的桥接实体。
Token 价值沿原型树向上求和。层—KV 头敏感度乘子刻画这一组件对模型输出的影响强弱。曲率和惊异度不会直接乘入相关性:它们塑造树的结构,而注意力证据为树节点定价。
子节点聚合到父节点时总价值守恒,因此同一信号既能为根节点的覆盖范围定价,也能为树中更深层的细化定价。
精确信息保护
姓名、数字、标签与少样本输出格式的收益可能并不平滑:抵达精确叶节点非常有用,但通往它的中间 Split 若逐步观察,可能显得没有那么值得。
因此,GraceKV 会在主竞价前,从高价值的 (层, KV 头, token) 叶节点中隔离出一个受预算上限约束的小集合。单例保底不免费、不在树外复制。
完整路径成本计入同一个硬物理预算;共享祖先只付费一次。
04 · 自顶向下的预算流
Add 比较的是完全丢弃与一个根节点覆盖;Split 比较的是父原型与更细的子节点集合。两者都按每个新增缓存条目的收益评分,因此早期层中的一次操作,可以直接与其他层、KV 头、语义槽或局部分辨率的操作竞争。这就是全局 Add/Split 竞价:全局指竞争范围,而非求得全局最优。
这里的数值只用于示意。真实队列横跨所有层、KV 头、语义槽以及当前已经暴露的树操作。
05 · 物理缓存打包
每个层—KV 头组合都会得到独立长度的不等长缓存。未被选中的根节点不产生条目;内部节点存储打包原型;单例节点存储原始 K/V。新生成的 token 以多重性 1 追加。
当预算恢复到 FullKV 规模时,每棵树都可以展开到 token 叶节点,并精确恢复原始上下文条目。
粗粒度原型 细化原型 精确 token
语义槽构建。多层、多尺度曲率在采样深度与窗口之间做稳定化;惊异度是较弱的辅助边界信号。默认语义槽长度为 16–128 个 token,目标为 64。
价值流。问题与序列尾部探针提供直接相关性的种子;默认权重 0.3 的两次图传播恢复间接证据。父节点价值等于子节点价值之和。
原型保真度。基于探针的失真以 0.25:0.75 加权注意力分布误差与 Value 聚合误差。构树时会同时考虑高曲率候选切分点和区间中点,也可以用三路子节点集合隔离一个显著 token。
单例保底机制。默认上限是可分配基础预算的 0.6,但这是硬上限,并不保证一定花掉 60%。每个最终实现的单例都要支付完整树路径成本。
效果与现实意义
核心结果不只是某一个基准上的孤立胜利。GraceKV 在需求相反的任务之间都保持竞争力:摘要与聚合需要广泛的覆盖范围,问答与检索则需要锐利的局部可寻址性。
广泛但较低的局部分辨率,可以避免整个主题或章节完全消失。
在漫长的干扰上下文中,姓名、数值与证据跳转需要精确条目或更细的 Split。
示例结构受益于覆盖范围,而标签与答案格式则受益于精确单例。
模型为 Qwen2.5-7B-Instruct。问答使用 F1,摘要与少样本使用 Rouge-L,所有数值均乘以 100。
| 任务 | FullKV | 4× | 8× | 16× | 32× | 64× | 128× |
|---|---|---|---|---|---|---|---|
| 单文档问答 | 43.95 | 42.97 | 41.58 | 38.45 | 35.57 | 31.49 | 25.81 |
| 多文档问答 | 29.86 | 30.18 | 29.90 | 28.78 | 28.18 | 27.09 | 25.19 |
| 摘要 | 15.97 | 15.03 | 14.51 | 14.04 | 13.48 | 12.58 | 11.88 |
| 少样本 | 36.23 | 35.82 | 34.77 | 33.92 | 33.80 | 33.18 | 32.83 |
如何解读质量曲线
在 4 倍压缩下,每个 LongBench 类别都保留了各自 FullKV 分数的至少 94%;到 16 倍时,四类任务仍保留约 87%–96%。128 倍是刻意设置的压力测试:模型仍保有可用行为,但损失会明显随任务而变化。
这些描述性比例按已发表表格中的每一行计算,并不是普适的质量保证。
预算收紧时的精确检索
RULER 集合召回率检查是否找回每一个远距离目标,因此它严格考验的是局部可寻址性,而不是近似语义相似度。在 Qwen2.5-7B-Instruct Retrieval 设置中,从 4 倍压缩收紧到 16 倍只损失 1.00 分,而从 16 倍收紧到 32 倍会损失 9.75 分。
30K 上下文下的效率
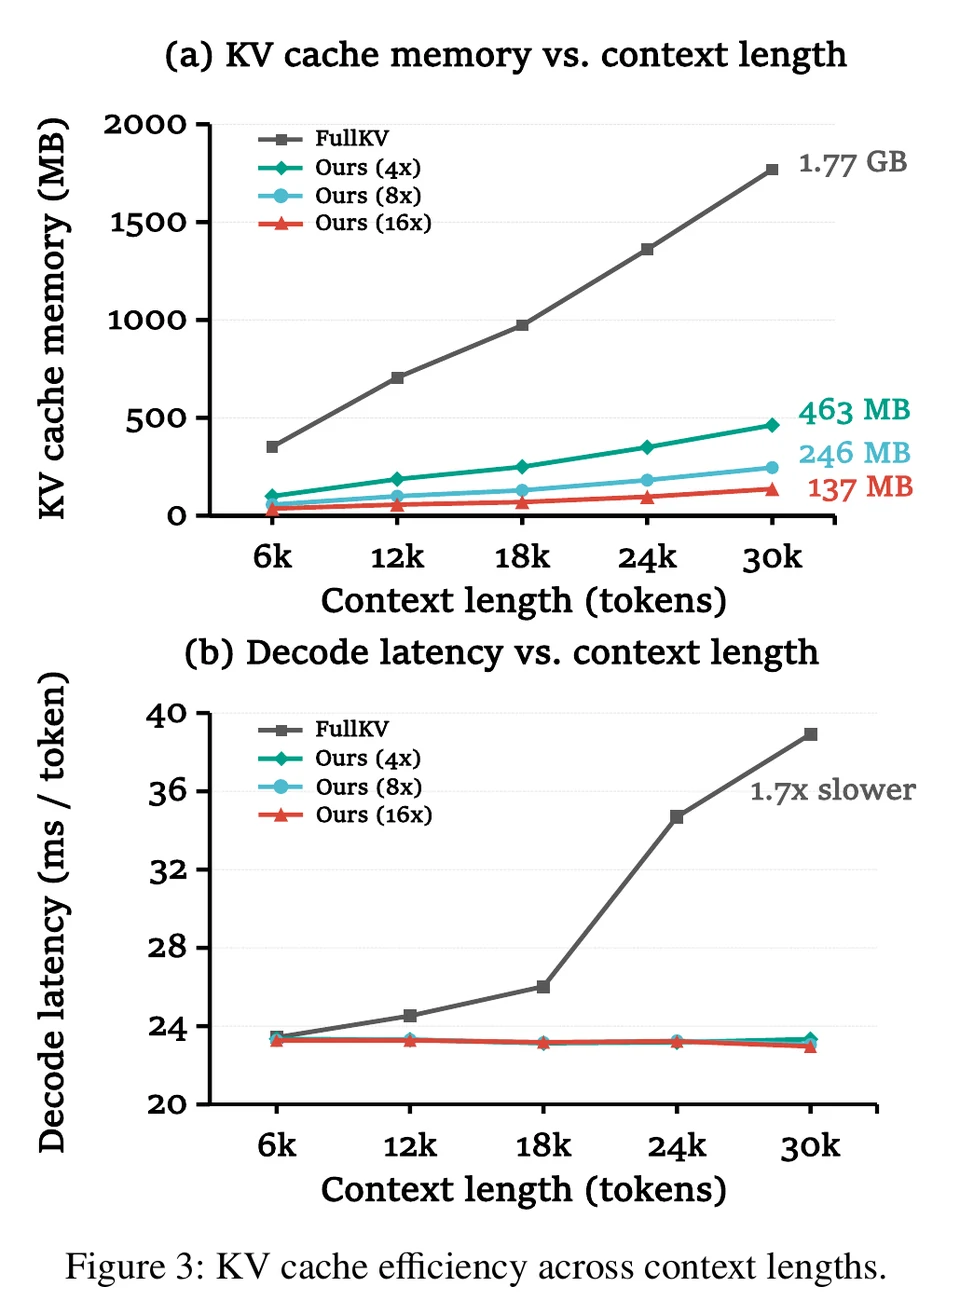
这分别比 FullKV 少用约 74%、86% 和 92% 的 KV 缓存显存。现实中,这份余量可能让更长上下文或更大批次成为可能,具体还取决于模型权重、激活、服务栈与可用 GPU 显存。
在同一个 1.77 GB、仅计算 KV 的显存范围内
在统一的固定缓存贪心解码器下,GraceKV 与 FullKV 通常都处在 23–25 ms/token。同一方法在不同数据集上可能稍快或稍慢,因此最稳健的结论是显存下降,速度收益仍取决于 kernel 与 workload。
产生主质量结果的默认路径,在下方五个详细 workload 上需要 3.00–21.53 秒。这笔成本在预填充后支付一次,也让原型树构建成为最需要继续优化的系统环节。
当显存是主要约束、同一上下文将支持很长的续写或多轮复用,或高压缩原本会抹去关键证据时,这种权衡最有吸引力。
8 倍压缩下的实测系统权衡
Qwen2.5-7B-Instruct;预填充后只压缩一次,随后使用固定 RaggedCache 与同一个贪心解码器。LongBench 每行约 200 个样本,RULER 每行 100 个样本。表中采用产生主质量结果的默认路径。
| Workload | FullKV 缓存 | GraceKV 缓存 | 剩余比例 | 解码:Full → Grace | 一次构建 |
|---|---|---|---|---|---|
| Qasper | 294.9 MiB | 51.7 MiB | 17.5% | 23.15 → 24.02 ms/token | 5.51 s |
| MultiNews | 181.3 MiB | 53.9 MiB | 29.7% | 23.23 → 23.33 ms/token | 3.00 s |
| SAMSum | 523.2 MiB | 93.7 MiB | 17.9% | 24.43 → 23.95 ms/token | 13.03 s |
| RULER-FWE | 877.0 MiB | 130.3 MiB | 14.9% | 25.63 → 24.06 ms/token | 20.41 s |
| RULER-MQNIAH | 887.4 MiB | 131.4 MiB | 14.8% | 25.17 → 23.28 ms/token | 21.53 s |
“剩余比例”指 GraceKV 缓存除以 FullKV 缓存。这些延迟只描述统一的一次压缩协议,并不是端到端服务指标,也不能外推到原生的逐步淘汰实现。
它在现实中可能改变什么
节省下来的 KV 缓存字节,可能支持更长的可服务上下文或更大批次。这些是部署层面的含义,而不是端到端服务测量;最终收益还取决于模型权重、激活、显存碎片与调度器。
更小的缓存可以让一份长报告、合同或论文集合中的更多内容常驻,同时不强迫每个章节获得相同局部分辨率。从同一份完整预填充状态重复生成,还可以摊薄构建成本。
代码仓库上下文、工具轨迹、实体名、数字与输出格式,把大量背景和少数精确事实混合在一起,恰好对应方法对覆盖范围与局部分辨率的联合分配。
当 KV 显存限制请求准入时,更小的物理缓存可能让系统在设备上保留更多会话,或减少驱逐、卸载缓存的压力。论文并未端到端测量这一行为。
如果生成很短、上下文很小,或注意力不受显存带宽限制,那么秒级的一次性构建成本可能超过稳态节省。因此论文将显存容量视为近期最主要的系统收益。
消融实验告诉我们什么
以下为 Qwen2.5-7B 单文档问答相对完整方法的分数变化;降幅越大,说明该组件承担的作用越关键。
每组数字分别是在 8 倍 / 64 倍压缩下的分数下降;完整方法对应 41.58 / 31.49。
引用
田昊霖、刘宇哲、王同翰,2026。Every Cache Entry Earns Its Place: Global Allocation of Resolution and Coverage for KV Cache Compression。arXiv:2608.07001。
@article{tian2026every,
  title   = {Every Cache Entry Earns Its Place: Global Allocation of Resolution and Coverage for KV Cache Compression},
  author  = {Tian, Haolin and Liu, Yuzhe and Wang, Tonghan},
  journal = {arXiv preprint arXiv:2608.07001},
  year    = {2026}
}